fig1
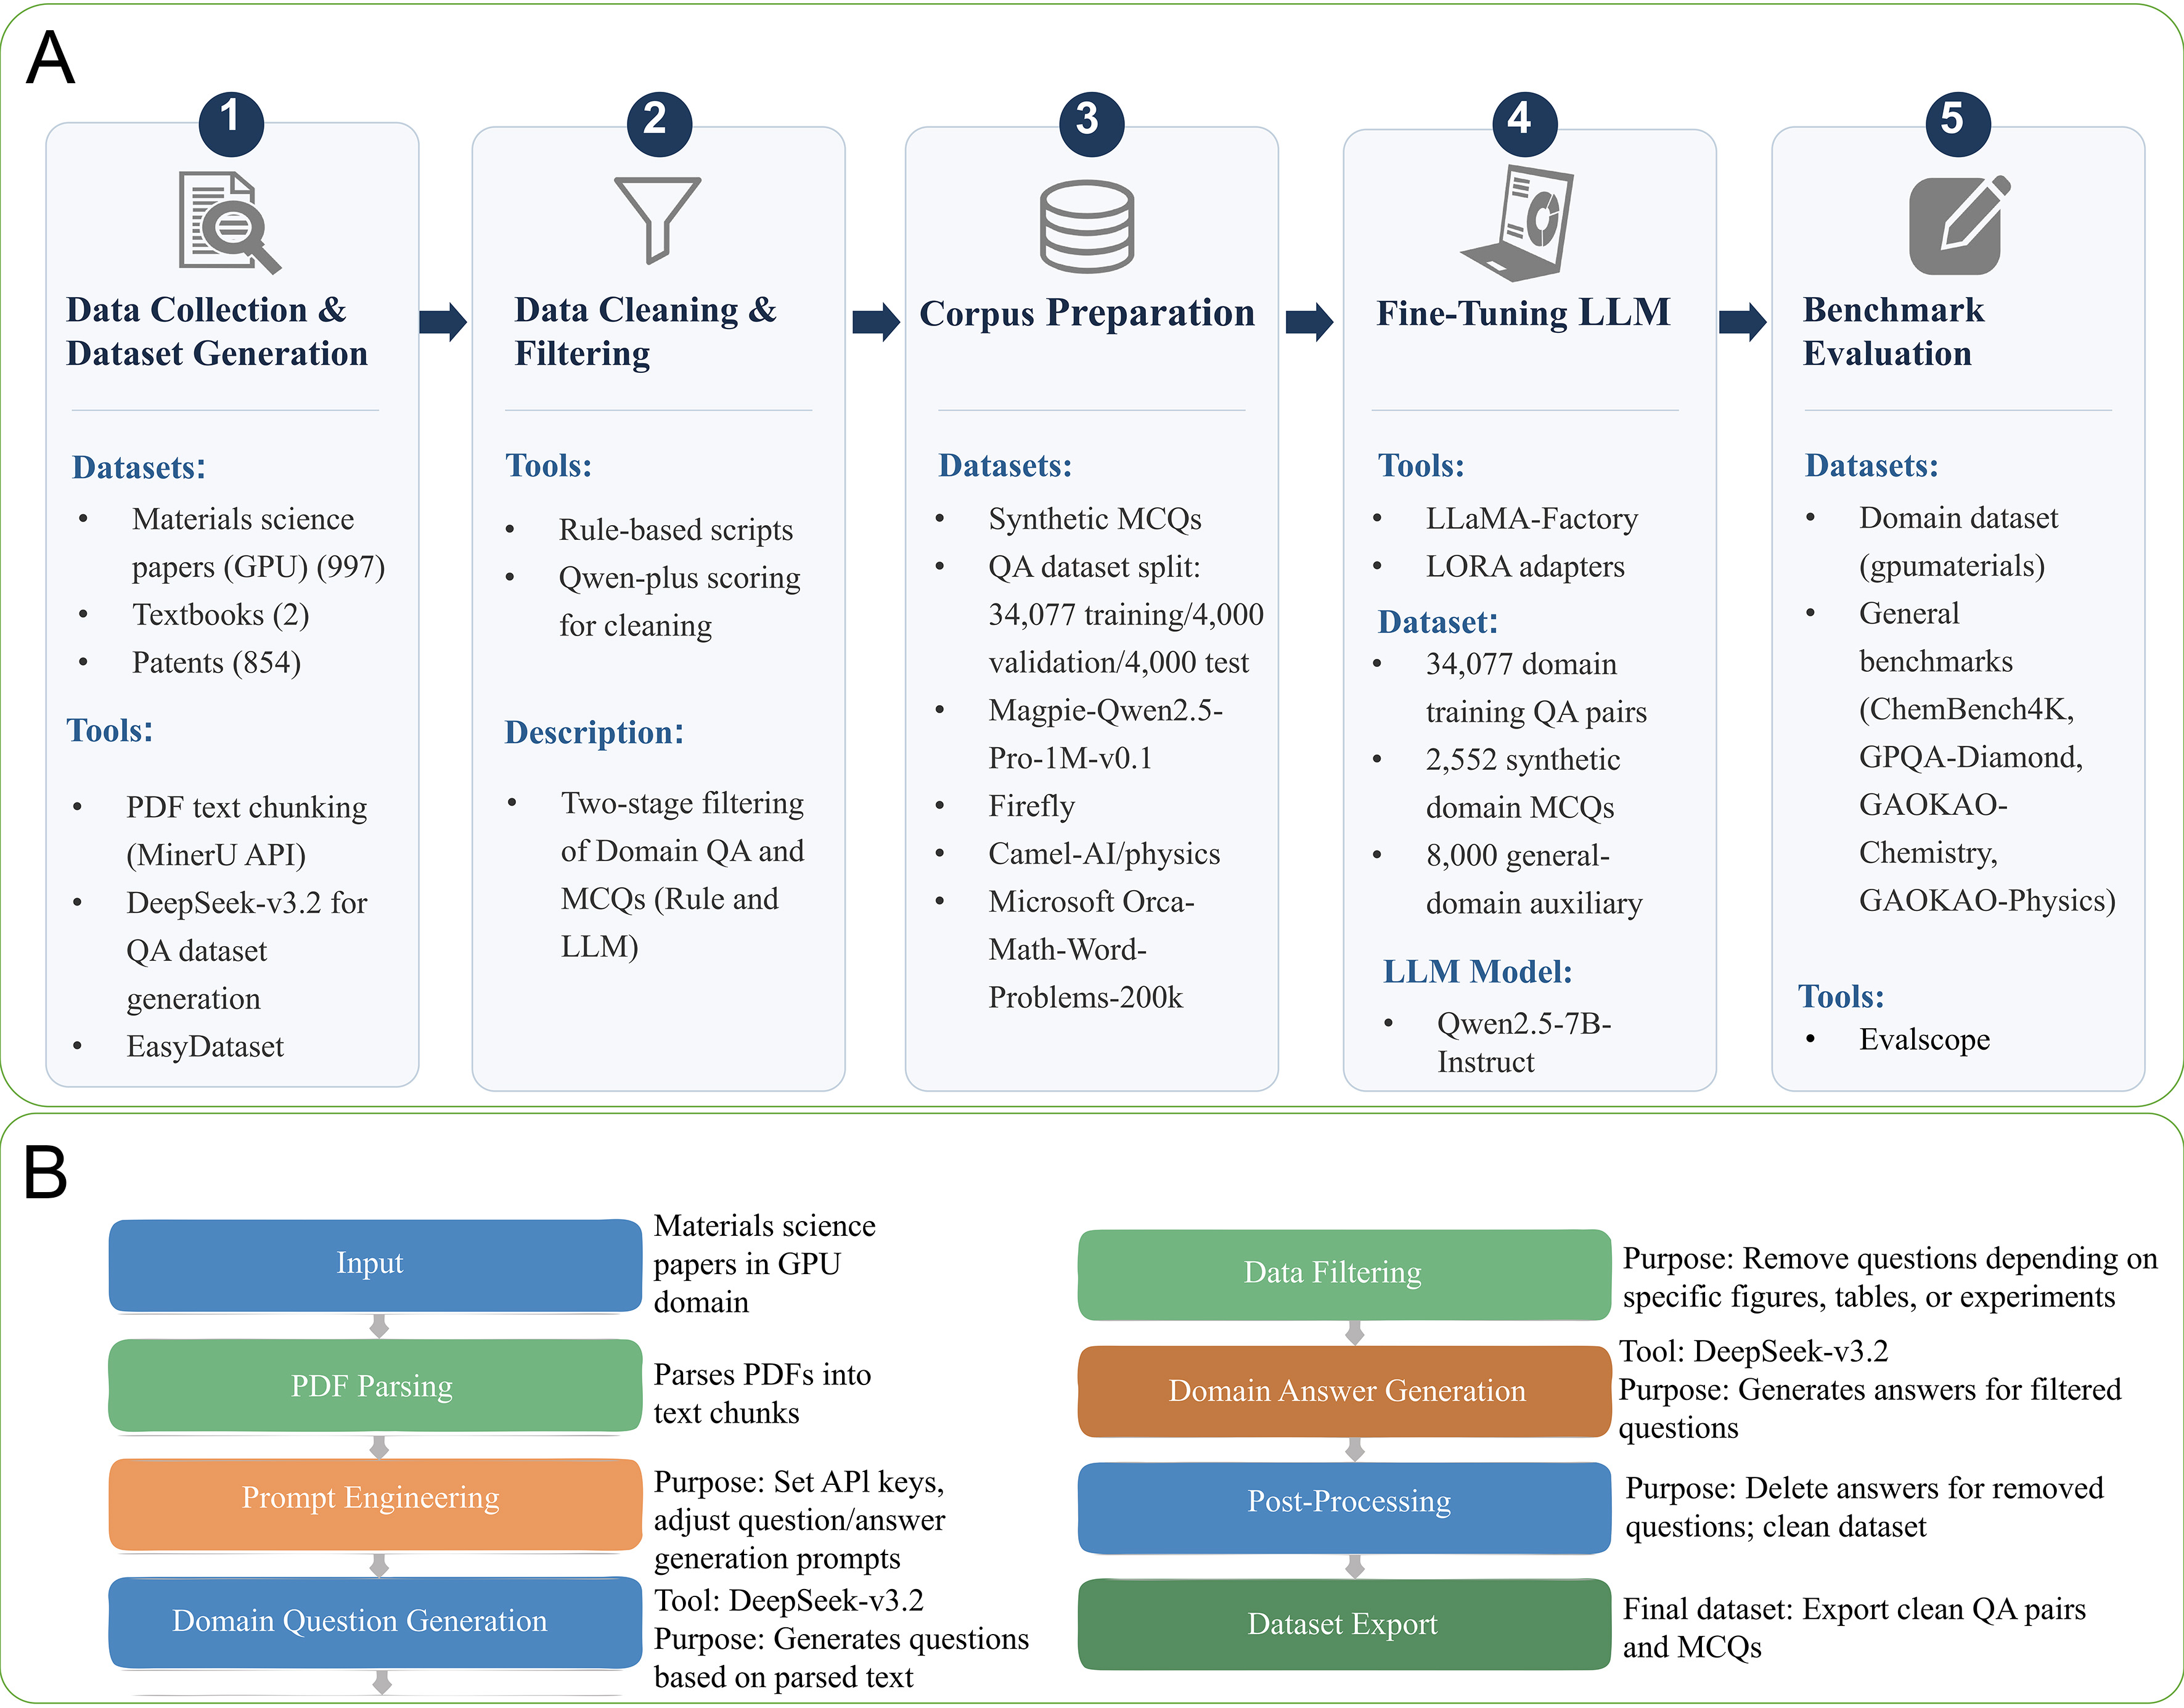
Figure 1. (A) Overall five-stage workflow of GPUmatLLM, covering data collection and dataset generation, data cleaning and filtering, corpus preparation, model fine-tuning, and benchmark evaluation; (B) Automated QA and MCQ dataset generation pipeline for GPUmatLLM. GPU: Graphics processing unit; API: application programming interface; QA: question-answer; MCQs: multiple-choice questions; LLM: large language model; GPQA: graduate-level Google-proof Q&A; LoRA: low-rank adaptation; PDF: portable document format.